01
Falhas detectadas mais cedo
A equipe recebe sinais antes que o impacto aumente.
 Falar com a RTX
Logs, métricas e alertas para detectar falhas mais cedo.
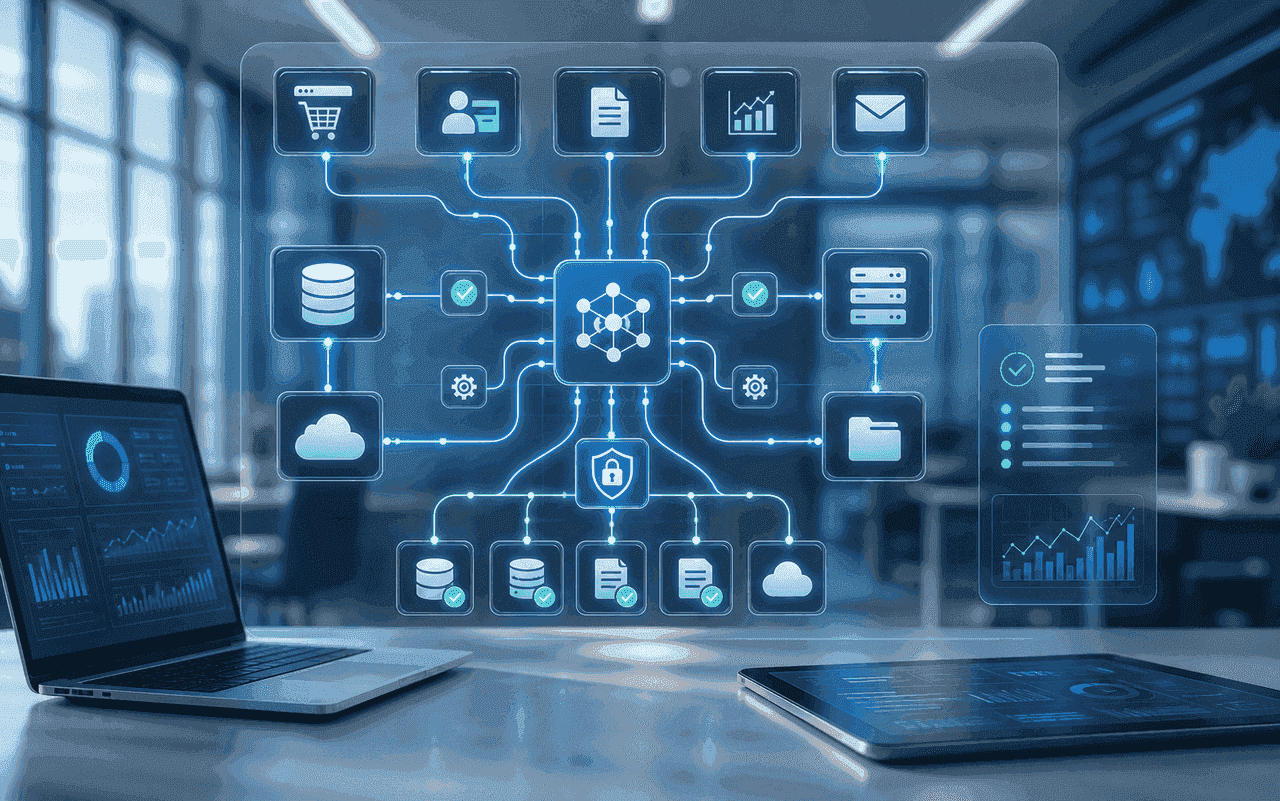
Métricas e alertas mostram falhas, lentidão e mudanças de comportamento.
A equipe só fica sabendo depois que usuários ou áreas internas percebem o problema.
Logs, métricas e alertas reduzem o tempo de detecção e resposta.
Falar com a RTXA equipe recebe sinais antes que o impacto aumente.
O acompanhamento mostra o que importa para a operação.
Cada alerta traz informações para iniciar a investigação.
A equipe recebe informações para investigar e agir.
Etapas combinadas com a sua equipe e contato direto com quem executa o trabalho.
Definimos os pontos críticos do sistema e das integrações.
Organizamos métricas, logs e rastreamento para mostrar onde a falha ocorre.
Configuramos alertas para os sinais de falha ou de degradação.
Revisamos alertas e incidentes para ajustar o monitoramento.
Em todos os formatos, o escopo é definido depois de avaliar o sistema e as prioridades da empresa.
Volume mensal de atendimento combinado para correções, melhorias e acompanhamento do sistema, com prioridades definidas em conjunto.
Indicado paraHoras contratadas conforme a necessidade para investigar uma falha, corrigir um problema ou fazer um ajuste específico.
Indicado paraEscopo, etapas e critérios de aceite combinados antes do início, para trabalhos com começo, meio e fim.
Indicado paraMonitoramento mostra sinais definidos previamente. Observabilidade ajuda a investigar comportamento, correlação e causa em sistemas, integrações e rotinas críticas.
Sim. Tarefas agendadas, filas, sincronizações, APIs e rotinas automatizadas podem receber métricas, logs e alertas que indiquem quando agir.
Alertas precisam representar desvio relevante, ter contexto de ação e acompanhar fluxos críticos, não apenas volume bruto de log ou evento técnico isolado.
A RTX define métricas e alertas para os sistemas críticos.